Chunking e Embeddings: Técnicas para Gerar Prompts Seguros em LLMs, Evitando Exposição de Dados Sigilosos e Alucinações
Bem-vindo de volta ao nosso blog sobre inteligência artificial, automação, robótica, e-commerce e gestão de projetos! Como gestores de equipes de programadores, vocês sabem que integrar LLMs (Large Language Models) de forma segura é essencial para impulsionar projetos sem riscos desnecessários. Nos posts anteriores, discutimos bancos de dados vetoriais, a técnica de Retrieval-Augmented Generation (RAG) e as alucinações em LLMs – problemas que podem comprometer a confiabilidade das aplicações de IA. Hoje, aprofundamos em duas técnicas fundamentais que suportam essas discussões: chunking e embeddings. Vamos explorar como elas permitem gerar prompts sem expor dados sigilosos, mitigar alucinações e abrir novas oportunidades em cenários como integração com n8n, Arduino ou metodologias ágeis.
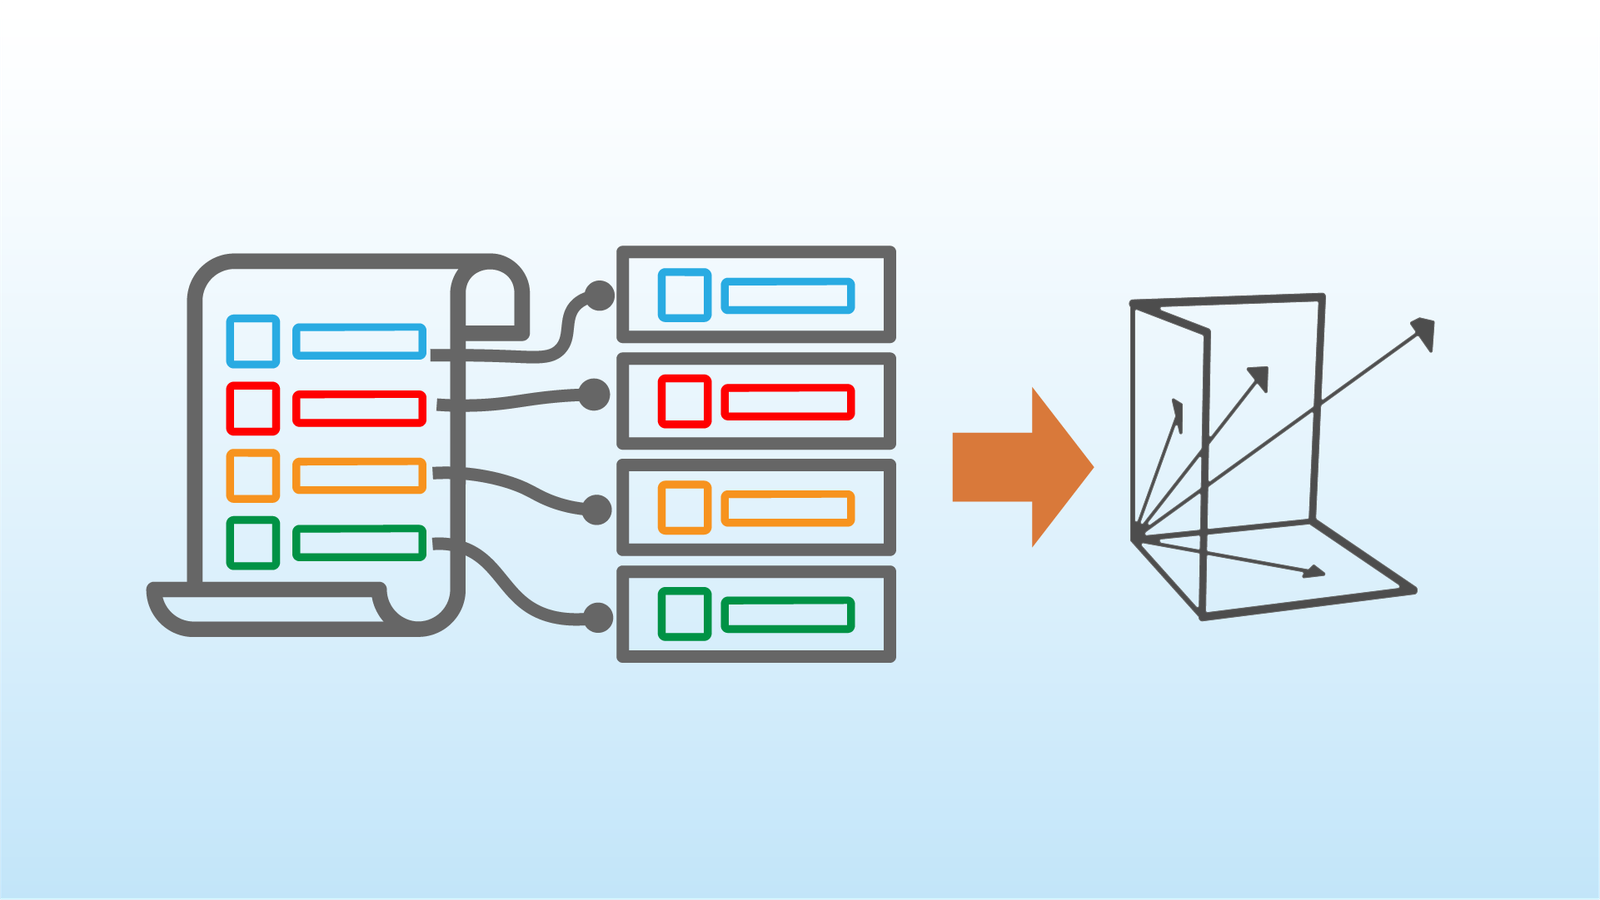
Pense em um projeto de e-commerce onde você precisa consultar dados confidenciais de clientes via LLM, sem enviar informações sensíveis para servidores externos. Chunking divide documentos em pedaços gerenciáveis, enquanto embeddings transformam esses pedaços em representações vetoriais para buscas semânticas eficientes. Juntas, essas técnicas formam a base de sistemas RAG seguros, reduzindo riscos de privacidade e erros factuais. Neste artigo, expandiremos o tema com visões teóricas, consequências práticas (como impactos regulatórios), oportunidades de negócio e exemplos reais. Como sempre, este é um artigo teórico; tutoriais "mão na massa" virão em posts futuros, como implementar chunking em fluxos n8n.
O que é Chunking? Dividindo para Conquistar em Processamento de Dados
Chunking refere-se à técnica de dividir textos ou documentos longos em segmentos menores (chunks) para facilitar o processamento por modelos de IA. Em vez de alimentar um LLM com um arquivo inteiro – o que pode exceder limites de tokens ou expor dados desnecessários –, você quebra o conteúdo em unidades lógicas, como parágrafos, frases ou tamanhos fixos (ex: 512 tokens).
Visões Teóricas e Estratégias de Chunking:
- Por Tamanho Fixo: Simples, mas pode cortar contextos no meio de frases, levando a perda de significado.
- Por Conteúdo Semântico: Usa modelos de IA para detectar breaks naturais, como mudanças de tópico, preservando coerência.
- Híbrido: Combina tamanho com semântica, otimizando para RAG.
Consequências: Chunking inadequado pode gerar chunks muito pequenos (aumentando overhead de buscas) ou grandes (excedendo limites de prompts, causando erros). Em 2025, com LLMs lidando com contextos maiores (até milhões de tokens), chunking ainda é crucial para eficiência computacional. Oportunidade: Em gestão de projetos, chunking permite analisar documentos extensos de requisitos sem sobrecarregar o LLM, acelerando revisões ágeis.
Exemplo inicial: Em um tutorial futuro, chunkar um manual de Arduino em pedaços de 200 tokens para indexação em um banco vetorial, permitindo consultas precisas sem expor o documento inteiro.
O que São Embeddings? Representações Vetoriais para Busca Semântica
Embeddings são representações numéricas de alta dimensionalidade (ex: vetores de 768 floats) que capturam o significado semântico de textos, imagens ou dados. Gerados por modelos como BERT ou embeddings da OpenAI, eles transformam dados em pontos em um espaço vetorial, onde a proximidade reflete similaridade (medida por cosine similarity).
Geração e Uso:
- Modelos Open-Source vs. Proprietários: Hugging Face para customização local (mais privado), vs. APIs como OpenAI para facilidade, mas com riscos de exposição.
- Aplicações em IA: Essenciais para RAG, onde embeddings de queries buscam chunks semelhantes em bancos vetoriais.
Consequências: Embeddings podem vazar informações sensíveis se não anonimizados (ex: via pseudonymization), levando a riscos de inferência reversa. Visão ética: Em contextos regulados como LGPD, embeddings ajudam a cumprir privacidade diferencial. Oportunidade: Em robótica, embeddings de dados de sensores Arduino permitem detecção de padrões sem compartilhar dados crus, impulsionando automação segura.
Exemplo: Converter descrições de produtos em e-commerce em embeddings para recomendações personalizadas, sem enviar textos completos para o LLM.
Usando Chunking e Embeddings para Gerar Prompts Seguros Sem Expor Dados Sigilosos
A combinação de chunking e embeddings é poderosa para criar prompts que consultam dados sem expô-los. Em RAG, você chunka documentos confidenciais, gera embeddings locais e armazena em bancos vetoriais privados (ex: Weaviate). Uma query é embeddada, busca chunks semelhantes e inclui apenas eles no prompt – sem enviar o dataset inteiro para o LLM.
Técnicas Avançadas para Segurança:
- Pseudonimização e Tokenização: Substitua dados sensíveis (ex: nomes) por placeholders antes de chunking, protegendo contra vazamentos.
- Embeddings Locais: Gere vetores em servidores internos, evitando APIs externas.
- Chunking Seletivo: Compartilhe apenas snippets relevantes, minimizando exposição.
Consequências: Sem essas técnicas, prompts podem expor dados via APIs de LLMs, violando regulamentações e causando breaches. Em 2025, com crescentes ataques de prompt injection, segurança é crítica. Oportunidade: Em e-commerce, prompts seguros via embeddings melhoram chatbots de suporte, aumentando satisfação sem riscos de privacidade, potencializando vendas em até 25%.
Visão empresarial: Integre com n8n para automação – um fluxo chunka documentos e gera embeddings automaticamente, alimentando RAG.
Mitigando Alucinações com Chunking e Embeddings
Alucinações ocorrem quando LLMs inventam fatos devido a falta de contexto. Chunking e embeddings mitigam isso via RAG: chunks embeddados fornecem evidências factuais, ancorando respostas. Estratégias incluem top-k retrieval (recuperar os K chunks mais semelhantes) e chain-of-thought prompting com embeddings.
Consequências: Chunking ruim pode recuperar chunks irrelevantes, piorando alucinações; embeddings de baixa qualidade (ex: de modelos desatualizados) reduzem precisão. Oportunidade: Em programação avançada, use embeddings para analisar código, evitando erros em integrações Arduino-n8n.
Exemplo prático: Em gestão de projetos, chunkar relatórios e embeddá-los permite que um LLM gere análises sem alucinar métricas, consultando apenas chunks relevantes.
Ferramentas para Implementar Chunking e Embeddings
- LangChain ou LlamaIndex: Bibliotecas Python para chunking semântico e geração de embeddings.
- Modelos de Embeddings: Sentence Transformers (open-source) ou OpenAI Embeddings.
- Bancos Vetoriais: Pinecone para armazenamento escalável.
Exemplo expandido: Em robótica, chunkar logs de sensores, gerar embeddings e usar em RAG para diagnósticos precisos sem exposição de dados proprietários.
Comparação: Estratégias de Chunking e Embeddings
Para clareza, uma tabela:
| Aspecto | Chunking Fixo | Chunking Semântico | Embeddings Locais | Embeddings em API |
|---|---|---|---|---|
| Vantagens | Simples, rápido | Preserva contexto | Alta privacidade | Fácil, preciso |
| Desvantagens | Pode cortar significados | Computacionalmente caro | Requer hardware | Risco de exposição |
| Uso em Segurança | Básico para divisão | Ideal para prompts seguros | Evita vazamentos | Com pseudonymização |
| Mitigação de Alucinações | Moderada | Alta, com retrieval melhor | Integra com RAG local | Dependente de provedor |
Essa comparação destaca trade-offs para escolhas estratégicas.
Conclusão: Chunking e Embeddings como Pilares para IA Segura e Confiável
Chunking e embeddings não são apenas técnicas; elas são ferramentas estratégicas para gerar prompts seguros, proteger dados sigilosos e combater alucinações em LLMs.